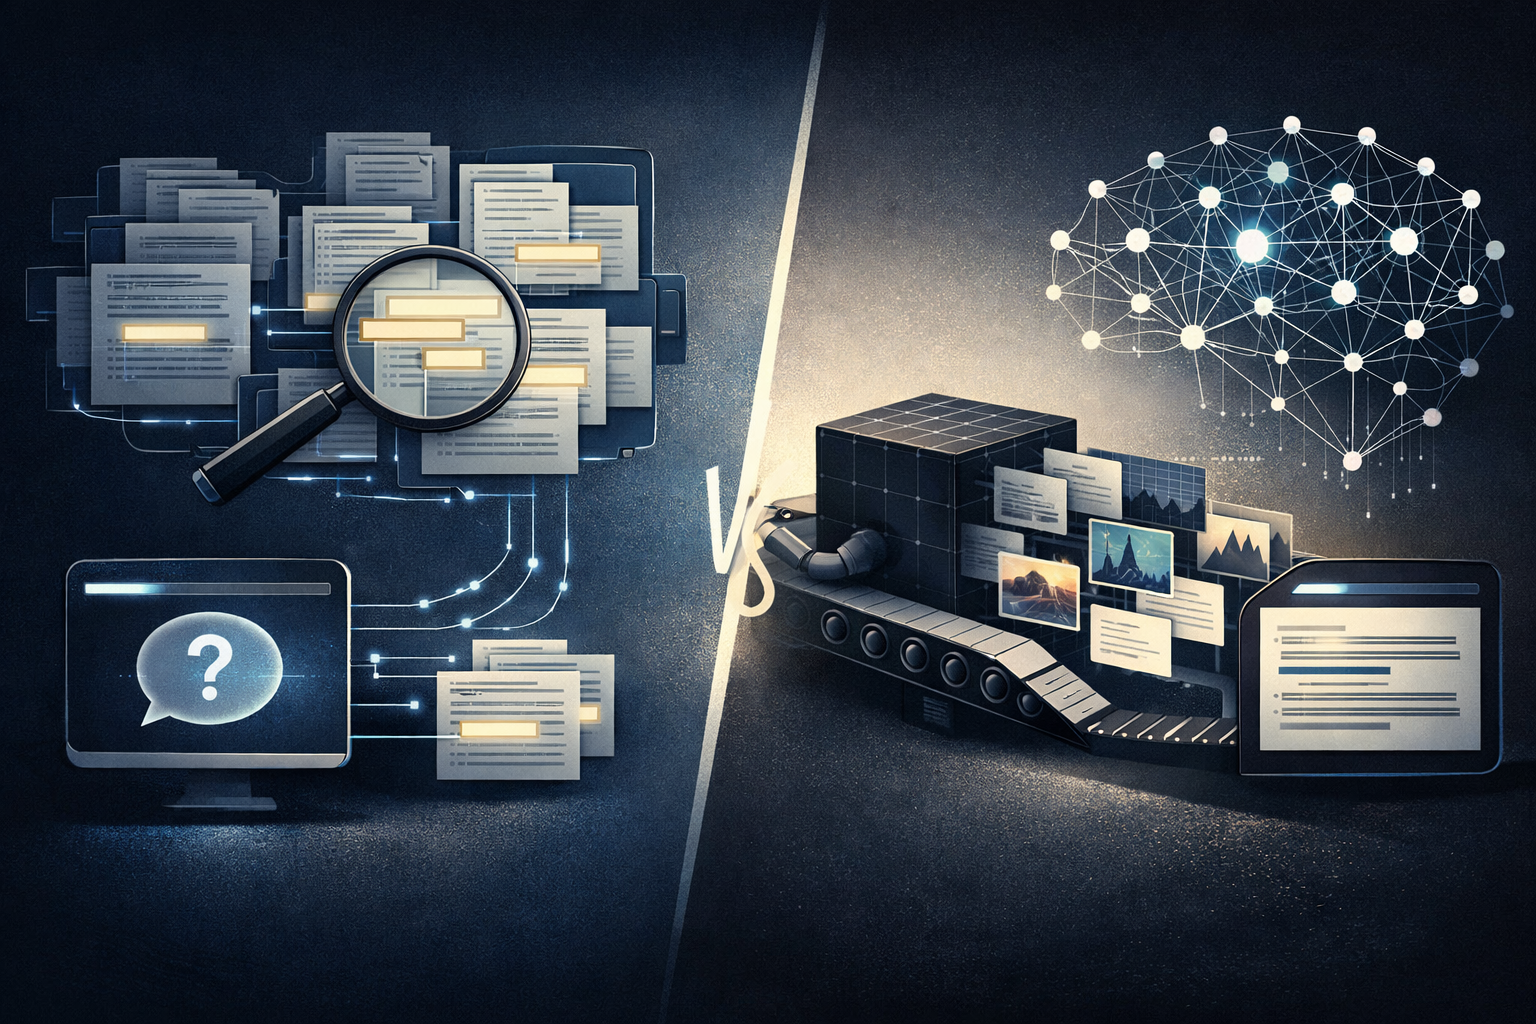
Fine-Tuning versus RAG ist keine Wahl zwischen zwei austauschbaren Methoden, um ein großes Sprachmodell klüger zu machen. Es geht um zwei unterschiedliche Formen der Anpassung: Die eine ruft zum Zeitpunkt der Anfrage relevante Informationen ab, die andere trainiert ein Modell darauf, sich bei einer klar definierten Aufgabe anders zu verhalten.
Für viele KI-Anwendungen im Produktivbetrieb lautet die beste Antwort nicht Entweder-oder. RAG kann die Fakten liefern. Fine-Tuning kann verbessern, wie das Modell diese Fakten nutzt, Anweisungen befolgt, Ausgaben formatiert oder einen spezialisierten Arbeitsablauf bearbeitet.
Fine-Tuning versus RAG: die Kurzfassung
Retrieval-Augmented Generation, kurz RAG, eignet sich, wenn Ihre Anwendung Antworten auf Basis externer Informationen geben muss: interne Dokumentation, Richtlinien, Produktkataloge, Supportartikel, juristische oder Compliance-Unterlagen oder anderes Wissen, das sich im Laufe der Zeit ändert.
Fine-Tuning eignet sich, wenn Ihre Anwendung ein konsistenteres Verhalten braucht: einen bestimmten Ton, ein Ausgabeformat, ein Klassifikationsschema, ein Extraktionsmuster, einen Workflow oder einen domänenspezifischen Antwortstil, der sich anhand von Beispielen zeigen lässt.
Beides sollten Sie einsetzen, wenn das System fundiertes Wissen und eine verlässliche Aufgabenausführung braucht. Ein verbreitetes Hybridmuster besteht darin, mit RAG relevanten Kontext abzurufen und anschließend ein feinabgestimmtes Modell zu nutzen, um diesen Kontext in einem vorhersehbaren Format oder Stil auszuwerten.
Der entscheidende Unterschied ist einfach:
- Bei RAG geht es vor allem darum, Antworten in externen Daten zu verankern.
- Beim Fine-Tuning geht es vor allem darum, das Verhalten eines Modells für eine Aufgabe zu verändern.
Microsoft beschreibt RAG als Möglichkeit, Modellausgaben auf Daten zu stützen, und weist in seiner Dokumentation zu RAG und Indizes in Microsoft Foundrydarauf hin, dass RAG und Fine-Tuning kombiniert werden können, statt sie als sich gegenseitig ausschließende Ansätze zu behandeln. OpenAI beschreibt überwachtes Fine-Tuning ebenfalls als Methode, um Modellverhalten anhand von Beispielen für eine bestimmte Aufgabe anzupassen, und zwar in seinem Leitfaden zum überwachten Fine-Tuning.
Was ist Retrieval-Augmented Generation?
Retrieval-Augmented Generation ist ein Architekturmuster, bei dem eine KI-Anwendung relevante Informationen aus einer externen Quelle abruft und diese Informationen in den Prompt des Modells einfügt, bevor eine Antwort erzeugt wird.
Ein typischer RAG-Ablauf sieht so aus:
- Ein Nutzer stellt eine Frage.
- Das System durchsucht einen Index, einen Dokumentenspeicher, eine Vektordatenbank, eine Suchmaschine oder eine andere Wissensquelle.
- Die relevantesten Inhaltsabschnitte werden dem Prompt als Kontext hinzugefügt.
- Das Sprachmodell erzeugt anhand des abgerufenen Kontexts eine Antwort.
- Je nach Design kann die Anwendung Zitate, Quellenverweise, Vertrauenssignale oder Anschlussoptionen enthalten.
RAG ist nützlich, weil das Modell nicht nur auf das angewiesen ist, was es beim Vortraining gelernt hat. Es kann Informationen nutzen, die zum Zeitpunkt der Anfrage abgerufen werden. Damit eignet sich RAG besonders für Wissensdatenbanken in Unternehmen, Kundensupportsysteme, Richtlinienassistenten, Bots für Produktdokumentation und Anwendungen, die aktuelle oder proprietäre Daten heranziehen müssen.
Die ursprüngliche Forschungsarbeit zu RAG stellte ein Modell vor, das parametrisches Gedächtnis mit abgerufenem nichtparametrischem Gedächtnis kombinierte. Die Ergebnisse dieser Arbeit beziehen sich jedoch auf die konkrete Architektur und die Experimente, die die Forschenden untersucht haben. Sie sollten nicht als Beleg dafür verallgemeinert werden, dass jede moderne kommerzielle RAG-Implementierung sich genauso verhält. Als Hintergrund zum Verständnis des Konzepts ist die Arbeit dennoch hilfreich; siehe die ursprüngliche RAG-Arbeit auf arXiv.
Was ist Fine-Tuning?
Fine-Tuning ist der Prozess, ein vorhandenes Modell anhand von Beispielen zu trainieren, damit es eine bestimmte Aufgabe besser erledigt oder einem gewünschten Muster zuverlässiger folgt.
Beim überwachten Fine-Tuning bestehen die Trainingsdaten in der Regel aus Eingabe-Ausgabe-Beispielen. Diese Beispiele zeigen dem Modell, wie eine gute Antwort für einen definierten Anwendungsfall aussehen soll. Mit der Zeit passt das Modell sein Verhalten in Richtung dieser Beispiele an.
Fine-Tuning wird häufig eingesetzt, wenn eine Anwendung Folgendes braucht:
- Eine konsistente Antwortstruktur
- Einen bestimmten Schreibstil oder Ton
- Domänenspezifische Formulierungen
- Zuverlässiges Klassifikationsverhalten
- Muster für die Extraktion strukturierter Daten
- Wiederholte Aufgabenbearbeitung, die sich allein mit Prompting nur schwer erreichen lässt
- Eine konsistentere Befolgung eines Workflows oder Entscheidungsmusters
Fine-Tuning ist in der Regel nicht die beste erste Wahl, um große Mengen sich ändernden Faktenwissens zu speichern. Wenn sich Informationen häufig ändern, kann ein RAG-System die zugrunde liegende Wissensquelle oder den Index oft aktualisieren, ohne das Modell neu zu trainieren. Fine-Tuning kann faktische Beispiele enthalten, doch es als Ersatz für eine aktuelle Wissensabrufschicht zu behandeln, kann Wartungs- und Zuverlässigkeitsprobleme verursachen.
Außerdem unterscheiden sich Verfügbarkeit, unterstützte Modelle, Preise und Regeln zum Umgang mit Daten beim Fine-Tuning je nach Anbieter und können sich ändern. Teams sollten die aktuelle Anbieterdokumentation prüfen, bevor sie sich architektonisch festlegen.
Kernunterschied: Wissensverankerung versus Verhaltensanpassung
Der häufigste Fehler in der Debatte Fine-Tuning versus RAG ist die Annahme, beide Ansätze lösten dasselbe Problem.
Das tun sie nicht.
RAG beantwortet die Frage: Welche Informationen soll das Modell jetzt nutzen?
Fine-Tuning beantwortet die Frage: Wie soll sich das Modell bei dieser Aufgabe verhalten?
Wenn Ihr Modell ausgefeilte, aber veraltete Antworten gibt, ist Fine-Tuning wahrscheinlich nicht die erste Lösung. Vermutlich brauchen Sie eine bessere Fundierung durch Abruf.
Wenn Ihr Modell Zugriff auf die richtigen Dokumente hat, aber trotzdem im falschen Format antwortet, den falschen Ton trifft oder Ihre Aufgabenregeln uneinheitlich anwendet, kann Fine-Tuning helfen.
In der Praxis beginnen viele Teams mit Prompting und RAG, weil das Modell auf eine vertrauenswürdige Wissensquelle zugreifen muss. Fine-Tuning ziehen sie später in Betracht, wenn Evaluationen wiederholte Verhaltensfehler zeigen, die sich durch bessere Prompts und ein besseres Retrieval-Design nicht beheben lassen.
Wann RAG sinnvoll ist
RAG eignet sich besonders, wenn die Anwendung Antworten aus externen, proprietären, veränderlichen oder prüfbaren Informationen erzeugen muss.
RAG für aktuelle oder häufig veränderte Informationen nutzen
Wenn die Antwort von Informationen abhängt, die sich im Laufe der Zeit ändern, passt RAG architektonisch meist besser als Fine-Tuning. Beispiele sind Produktverfügbarkeit, Preisregeln, Richtlinienaktualisierungen, Release Notes, Supportdokumentation und interne Verfahren.
Mit RAG kann das System die neuesten verfügbaren Inhalte aus einem Index oder einer Wissensquelle abrufen. Das garantiert nicht, dass die Antwort immer korrekt ist, vermeidet aber, sich ausschließlich auf die Trainingsdaten des Modells zu verlassen.
RAG für proprietäres oder internes Wissen nutzen
Viele Geschäftsanwendungen erfordern, dass das Modell auf Basis unternehmensspezifischer Materialien antwortet: Sales-Enablement-Dokumente, HR-Richtlinien, technische Handbücher, Standardarbeitsanweisungen oder Kundensupportartikel.
RAG kann das Modell zum Zeitpunkt der Anfrage mit diesem Material verbinden. So können Teams Wissen in verwalteten Repositorien halten, statt zu versuchen, alles in Modellgewichte zu codieren.
RAG nutzen, wenn Zitate oder Nachvollziehbarkeit wichtig sind
Wenn Nutzer sehen müssen, woher eine Antwort stammt, ist RAG oft der bessere Ausgangspunkt. Ein RAG-System kann so gestaltet werden, dass es Quelldokumente, Passagen oder Links anzeigt, die die Antwort beeinflusst haben.
Das ist besonders nützlich für Unternehmenssuche, Compliance-Prüfung, juristische Unterstützung, technischen Support und andere Workflows, in denen Nutzer Belege statt unbelegter Prosa brauchen.
Zitate sollten dennoch sorgfältig geprüft werden. Ein System kann relevante Dokumente abrufen und trotzdem eine Antwort erzeugen, die diese überzeichnet, falsch liest oder unvollständig nutzt. Retrieval-Qualität, Chunking, Ranking, Prompt-Design und Modellverhalten beeinflussen alle die Zuverlässigkeit.
RAG für wissensintensive Assistenten nutzen
RAG eignet sich gut für Assistenten, die Fragen über große Dokumentensammlungen beantworten. Beispiele sind:
- Assistenten für Kundensupport-Wissensdatenbanken
- Interne IT-Helpdesk-Bots
- Assistenten für Entwicklerdokumentation
- Assistenten für Richtlinien und Verfahren
- Produkt-Q&&A-Tools
- Forschungs- und Wissensmanagementsysteme
In diesen Fällen besteht die Hauptaufgabe oft nicht darin, dem Modell einen neuen Stil beizubringen. Sie besteht darin, dem Modell zur richtigen Zeit Zugriff auf die richtigen Informationen zu geben.
Wann Fine-Tuning sinnvoll ist
Fine-Tuning eignet sich besonders, wenn sich das gewünschte Verhalten durch hochwertige Beispiele definieren lässt und das Modell eine Aufgabe konsistenter erledigen soll.
Fine-Tuning für ein konsistentes Ausgabeformat nutzen
Wenn das Modell wiederholt nicht die Struktur erzeugt, die Ihre Anwendung braucht, kann Fine-Tuning helfen. Vielleicht benötigen Sie etwa Antworten, die einem bestimmten Schema, einem Satz von Klassifikationslabels, einem Datenextraktionsformat oder einer Workflow-Antwortvorlage folgen.
Prompting kann das anfangs oft lösen. Ist das Format jedoch komplex, wiederkehrend oder geschäftskritisch, kann Fine-Tuning das Verhalten für die Zielaufgabe konsistenter machen.
Fine-Tuning für Markenstimme oder Antwortstil nutzen
Fine-Tuning kann helfen, Antworten an einen gewünschten Ton oder Schreibstil anzupassen, wenn sich dieser Stil anhand von Beispielen demonstrieren lässt. Das kann für kundenorientierte Assistenten, Sales-Enablement-Tools oder Workflows im Content-Betrieb nützlich sein.
Entscheidend ist die Qualität der Beispiele. Ein feinabgestimmtes Modell lernt aus den Mustern, die ihm gezeigt werden. Uneinheitliche oder minderwertige Beispiele können zu uneinheitlichen Ergebnissen führen.
Fine-Tuning für domänenspezifisches Aufgabenverhalten nutzen
Manche Aufgaben erfordern mehr als Zugriff auf Fakten. Sie verlangen eine konsistente Art, einen Workflow zu durchdenken, Labels anzuwenden, strukturierte Felder zu extrahieren oder zwischen vordefinierten Antwortkategorien zu wählen.
Fine-Tuning kann nützlich sein für:
- Klassifikationsaufgaben
- Strukturierte Extraktion
- Routing- oder Triage-Entscheidungen
- Umschreiben von Inhalten in ein konsistentes Format
- Anwendung domänenspezifischer Formulierungen
- Befolgung wiederkehrender aufgabenspezifischer Anweisungen
Das bedeutet nicht, dass Fine-Tuning perfekte Genauigkeit garantiert. Es bedeutet, dass es ein nützliches Anpassungswerkzeug sein kann, wenn das gewünschte Ausgabemuster klar definiert und in Trainingsbeispielen abgebildet ist.
Fine-Tuning nutzen, wenn Prompting repetitiv oder brüchig wird
Einige Anwendungen stützen sich auf lange Prompts, die immer wieder dieselben Verhaltensregeln erklären. Fine-Tuning kann in manchen Fällen verringern, wie oft diese Regeln in jedem Prompt erneut formuliert werden müssen.
Allerdings hängen Latenz- und Kosteneffekte von der Implementierung ab. Ein feinabgestimmtes Modell kann die Prompt-Länge reduzieren, doch die Gesamtwirkung hängt von Modell, Anbieterpreisen, Traffic, Infrastruktur und Anwendungsdesign ab.
Wann beides zusammen sinnvoll ist
RAG und Fine-Tuning können einander ergänzen.
Eine hybride Architektur sieht oft so aus:
- RAG ruft relevante Dokumente oder Daten ab.
- Der Prompt stellt dem Modell diesen Kontext bereit.
- Ein feinabgestimmtes Modell wendet auf die abgerufenen Informationen ein konsistentes Aufgabenmuster, einen Ton, ein Format oder einen Entscheidungsprozess an.
Das kann nützlich sein, wenn die Anwendung sowohl faktische Fundierung als auch vorhersehbares Verhalten braucht.
Ein Supportassistent kann beispielsweise mit RAG relevante Produktdokumentation abrufen und anschließend Fine-Tuning nutzen, um Antworten in einem konsistenten Troubleshooting-Format zu erzeugen. Ein Richtlinienassistent kann die aktuelle HR-Richtlinie abrufen und ein feinabgestimmtes Modell verwenden, um sie in einem standardisierten, mitarbeiterorientierten Stil zusammenzufassen. Ein Workflow zur Dokumentenverarbeitung kann Referenzleitlinien abrufen und Fine-Tuning nutzen, um Felder in einem konsistenten Schema zu extrahieren.
Der hybride Ansatz ist besonders nützlich, wenn das Modell Zugriff auf die richtigen Informationen hat, die Aufgabe aber dennoch falsch handhabt. RAG liefert den Inhalt. Fine-Tuning verbessert, wie das Modell ihn nutzt.
Entscheidungsmatrix: Fine-Tuning versus RAG
| Entscheidungsfaktor | RAG ist meist besser geeignet, wenn … | Fine-Tuning ist meist besser geeignet, wenn … |
|---|---|---|
| Datenaktualität | Die Antwort von aktuellen oder häufig aktualisierten Informationen abhängt. | Das Aufgabenverhalten stabil ist und nicht primär von sich ändernden Fakten abhängt. |
| Proprietäres Wissen | Das Modell interne Dokumente, Richtlinien oder Produktdaten nutzen muss. | Das Modell unternehmensspezifisches Verhalten, einen bestimmten Ton oder eine bestimmte Formatierung befolgen soll. |
| Faktische Fundierung | Sie Antworten benötigen, die auf abgerufenen Quellen beruhen. | Das Modell für eine definierte Aufgabe in einem zuverlässigeren Muster antworten soll. |
| Ausgabekonsistenz | Retrieval die benötigten Fakten liefert, die Formatierung aber möglicherweise weiterhin Prompt-Design erfordert. | Das Hauptproblem in uneinheitlicher Struktur, uneinheitlichen Labels, uneinheitlichem Ton oder inkonsistenter Workflow-Ausführung liegt. |
| Wartung | Sie Quellinhalte oder Indizes aktualisieren wollen, ohne neu zu trainieren. | Sie einen kuratierten Trainingsdatensatz pflegen und aktualisieren können, wenn sich Verhaltensanforderungen ändern. |
| Prüfbarkeit | Nutzer Quellenverweise oder Nachvollziehbarkeit bis zu Dokumenten benötigen. | Nutzer vor allem konsistente Aufgabenleistung brauchen statt quellenbelegter Antworten. |
| Evaluationsfokus | Retrieval-Relevanz, Antworttreue, Zitierqualität und Abdeckung am wichtigsten sind. | Aufgabengenauigkeit, Formattreue, Tonkonsistenz und Abdeckung durch Beispiele am wichtigsten sind. |
| Latenz | Retrieval zusätzliche Schritte einführt, sodass die Leistung von Suche, Ranking und Generierungsdesign abhängt. | Fine-Tuning in manchen Fällen die Prompt-Länge reduzieren kann, die Latenz aber vom Modell und der Bereitstellung abhängt. |
| Sicherheit und Datenschutz | Kontrollen von Datenquellen, Retrieval-Schicht, Anbieter, Bereitstellung und Zugriffsregeln abhängen. | Kontrollen vom Trainingsprozess, Anbieter, der Bereitstellung und Richtlinien zum Umgang mit Daten abhängen. |
Diese Matrix ist eine Orientierung, keine allgemeingültige Regel. Es gibt keine belastbare Pauschalaussage, dass RAG oder Fine-Tuning immer günstiger, schneller, genauer oder sicherer ist. Diese Ergebnisse hängen von Implementierung, Modellauswahl, Datenqualität, Traffic-Mustern, Evaluationsdesign, Anbieterpreisen und betrieblichen Anforderungen ab.
Häufige Missverständnisse
Missverständnis 1: Fine-Tuning ist der beste Weg, neues Wissen hinzuzufügen
Fine-Tuning kann beeinflussen, was ein Modell aus Beispielen lernt, ist aber in der Regel nicht der beste Weg, große Mengen sich ändernden Faktenwissens zu verwalten. Wenn die Anwendung aktuelle oder proprietäre Informationen braucht, ist RAG oft der bessere Ausgangspunkt, weil es Informationen zum Zeitpunkt der Anfrage aus einer externen Quelle abruft.
Missverständnis 2: RAG beseitigt Halluzinationen
RAG kann die Fundierung verbessern, garantiert aber keine faktische Korrektheit. Ein RAG-System kann weiterhin scheitern, wenn der Abruf das richtige Dokument verfehlt, irrelevanten Kontext liefert, Inhalte schlecht in Chunks aufteilt, Passagen falsch rankt oder das Modell unzureichend promptet. Das Modell kann abgerufene Informationen außerdem falsch interpretieren.
RAG reduziert bei gutem Design bestimmte Risiken, ist aber kein Allheilmittel gegen Halluzinationen.
Missverständnis 3: Fine-Tuning und RAG schließen sich gegenseitig aus
Sie lassen sich kombinieren. Microsoft stellt sie ausdrücklich als Ansätze dar, die zusammenarbeiten können, und viele praktische Architekturen nutzen Retrieval zur Wissensverankerung und Fine-Tuning zur Verhaltensanpassung.
Missverständnis 4: Ein Ansatz ist immer günstiger oder schneller
Kosten und Latenz hängen von den Details ab. RAG kann zusätzliche Schritte für Retrieval, Ranking und Kontextaufbereitung einführen. Fine-Tuning kann in manchen Anwendungen die Prompt-Länge reduzieren. Garantiert ist jedoch keines dieser Ergebnisse. Preise, Infrastruktur, Modellauswahl, Caching, Traffic-Volumen und Anbieterbedingungen spielen alle eine Rolle.
Missverständnis 5: Fine-Tuning verbessert automatisch jede Aufgabe
Fine-Tuning hängt von Qualität und Relevanz der Trainingsbeispiele ab. Wenn die Aufgabe schlecht definiert ist oder die Trainingsdaten uneinheitlich sind, löst Fine-Tuning das Problem möglicherweise nicht. Teams sollten zuerst prüfen, ob Prompt-Design, Tool-Nutzung, Retrieval-Qualität oder Änderungen am Workflow das Problem beheben würden.
Evaluationscheckliste vor der Entscheidung
Bevor Sie sich auf RAG, Fine-Tuning oder einen hybriden Ansatz festlegen, erstellen Sie einen Evaluationsdatensatz, der die reale Nutzung abbildet.
Dazu gehören:
- Repräsentative Nutzerfragen oder Aufgaben
- Erwartete Antworten oder Goldstandard-Ausgaben, soweit möglich
- Grenzfälle und mehrdeutige Anfragen
- Beispiele mit veralteten, fehlenden oder widersprüchlichen Informationen
- Sicherheits- und Zugriffskontrollszenarien, wenn das System private Daten nutzt
- Kriterien für die menschliche Bewertung der Antwortqualität
Bei RAG-Systemen sollten Sie evaluieren:
- Ob der Retriever die richtigen Quellinhalte findet
- Ob das Chunking ausreichend Kontext erhält
- Ob das Ranking die besten Passagen nach oben bringt
- Ob die erzeugte Antwort dem abgerufenen Kontext treu bleibt
- Ob Zitate oder Quellenverweise korrekt und nützlich sind
- Ob das System angemessen mit fehlenden Informationen umgeht
Bei feinabgestimmten Systemen sollten Sie evaluieren:
- Aufgabengenauigkeit
- Formattreue
- Konsistenz von Ton und Stil
- Leistung bei Beispielen, die im Training nicht vorkamen
- Fehlermodi bei Grenzfällen
- Ob das Modell dem gewünschten Workflow ohne übermäßiges Prompting folgt
Bei hybriden Systemen sollten Sie beide Schichten gemeinsam evaluieren. Ein hochwertiger Retriever garantiert keine gute endgültige Antwort, und ein gut abgestimmtes Modell kann nicht zuverlässig aus Dokumenten antworten, die es nie erhält.
Praxisdiagnose: Vor dem Training die Fehlerquelle bestimmen
Viva Paradox hat diese fiktive Supportübung erstellt, um die Auswahl überprüfbar zu machen. Eingaben und Referenzantworten sind didaktische Beispiele, keine gemessenen Modellausgaben oder Ergebnisse eines Fine-Tuning-Experiments.
Das fiktive Produkt heißt DemoBox. Das ausgemusterte Dokument R1 nennt 30 Tage Aufbewahrung für Standard-Backups. Das aktuelle Dokument R2 ersetzt ausdrücklich R1 und nennt 14 Tage. R2 definiert außerdem OUTAGE als „Dienst nicht verfügbar“ und DEGRADED als „Dienst verfügbar, aber langsam“. Diese Regeln gehören zur Übung und sind keine echte Produktspezifikation.
Beantworte nur anhand der bereitgestellten aktuellen Referenz: Wie lange werden Standard-Backups aufbewahrt? Gib JSON mit answer und source_id zurück. Fehlt die Referenz, erkläre, dass die Antwort nicht feststeht. Ersetze sie nicht durch ältere Dokumente.
Referenzantwort mit R2: answer nennt 14 Tage und source_id lautet R2. Gültiges JSON reicht nicht aus: 30 Tage wären weiterhin ein sachlicher Fehler.
| Beobachteter Fehler in der Übung | Zuerst zu testende Änderung | Nachweis vor weiteren Maßnahmen |
|---|---|---|
| Im abgerufenen Kontext steht nur R1; die Antwort nennt 30 Tage. | Datenübernahme, Versionsmetadaten, Filter für ausgemusterte Dokumente und Retrieval korrigieren. Prüfen, ob R2 das Modell erreicht. | Abgerufene Dokument-IDs und Versionen protokollieren. Ein anderer trainierter Schreibstil repariert keinen veralteten Index. |
| R2 liegt vor; die Antwort nennt korrekt 14 Tage, ergänzt aber Text außerhalb des JSON. | Zuerst einen klareren Prompt, unterstützte schemaabhängige Ausgabebeschränkungen und Validierung in der Anwendung testen. | Parsing-/Schemafehler getrennt von sachlichen Fehlern erfassen. Ein einzelner Formatfehler rechtfertigt noch kein Fine-Tuning. |
| Trotz R2 wird „verfügbar, aber langsam“ wiederholt als OUTAGE statt DEGRADED klassifiziert. | Definitionen und Beispiele prüfen. Eine Prompt-Baseline vergleichen; Fine-Tuning erst bei anhaltenden Aufgabenfehlern und geeigneten gelabelten Daten erwägen. | Mit zurückgehaltenen Fällen testen. Für eine exakt festgelegte Regel kann gewöhnlicher Anwendungscode einfacher sein als ein trainierter Klassifikator. |
| Ein Nutzer erhält ein eingeschränktes Teamdokument ohne Leseberechtigung. | Berechtigungen vor der Generierung im Retrieval und in der Anwendung erzwingen. | Mit Konten unterschiedlicher Berechtigung testen. Weder ein Ablehnungs-Prompt noch Fine-Tuning ersetzt Zugriffskontrollen. |
Ein kleiner Vergleich zum selbst Durchführen
Einen separaten Testsatz mit Fragen zu aktuellen Dokumenten, fehlenden Referenzen, OUTAGE/DEGRADED-Beispielen und Berechtigungsprüfungen erstellen. Fragen und Referenzantworten vor dem Vergleich festlegen; Testfälle nicht in Trainingsdaten kopieren. Für drei Generierungsvarianten Evaluierungseingaben, Quellversionen, Retrieval-Konfiguration und Basismodellfamilie soweit möglich konstant halten: (1) Prompt mit aktuellen Referenzen, (2) dasselbe System mit besseren Anweisungen oder unterstützten Ausgabebeschränkungen, (3) eine Fine-Tuning-Variante nur bei begründetem Bedarf. Unvermeidbare Unterschiede dokumentieren. Retrieval- und Berechtigungsreparaturen getrennt testen, um ihre Wirkung nicht dem Training zuzuschreiben.
Je Fall erfassen: Wurde die benötigte Quelle gefunden? Ist die Antwort belegt? Ist die Struktur gültig? Stimmt das Label? Fehlgeschlagene Berechtigungsprüfungen, gesamte Antwortzeit und Kosten separat notieren. Anzahlen mit Nenner berichten und abweichende Ergebnisse prüfen. Ein Gesamtwert kann ein System verbergen, das korrektes JSON mit veralteten Fakten ausgibt. Die Übung behauptet keine gemessenen Verbesserungen bei Genauigkeit, Geschwindigkeit oder Kosten.
Die kleinste Änderung wählen, die den beobachteten Fehler auch bei ungesehenen Fällen behebt. Für wechselnde Fakten Retrieval beibehalten; Training bei nachgewiesenen Verhaltensproblemen erwägen. Eine hybride Lösung ist ein zu prüfender Kandidat, keine automatische Pflicht.
Hintergrund: Microsoft unterscheidet Retrieval für private oder wechselnde Daten von Fine-Tuning für Verhalten, Stil und Aufgabenleistung. Die Diagnosefälle oben sind unsere eigenen Lehrbeispiele.
Ein reproduzierbares Beispiel für Retrieval und Versionsauswahl bietet unser RAG-Praxisleitfaden.