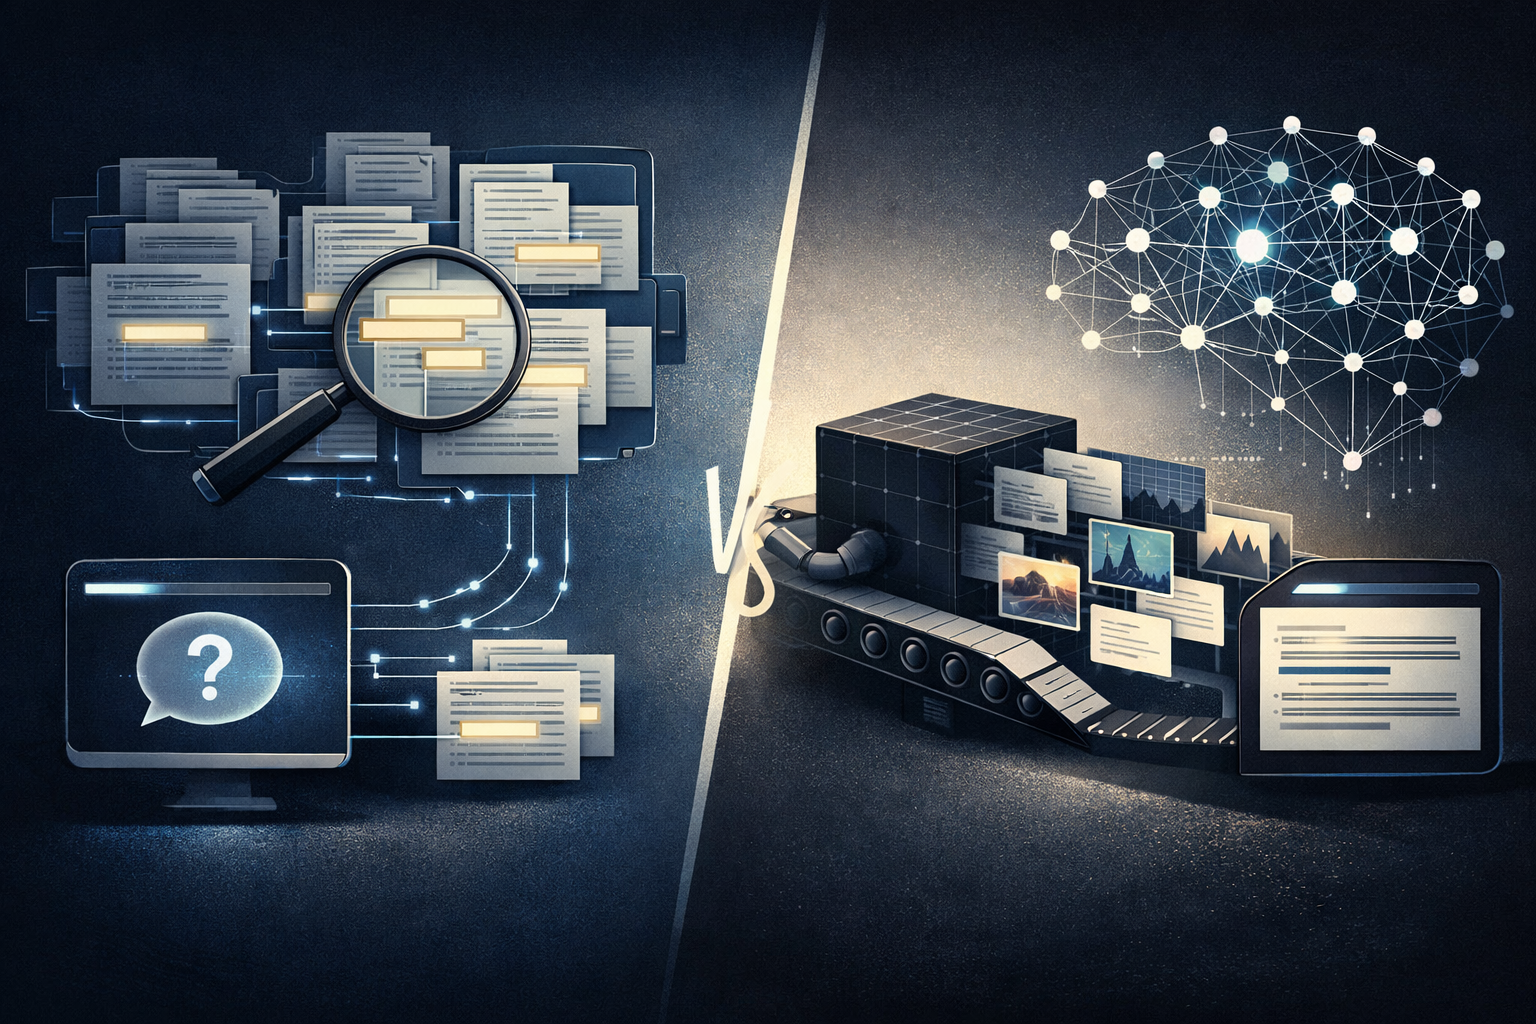
ファインチューニングとRAGの比較は、大規模言語モデルを賢くするための、置き換え可能な二つの方法のどちらを選ぶか、という話ではありません。これは、二つの異なるカスタマイズパターンの選択です。一方はクエリ時に関連情報を検索し、もう一方は定義されたタスクに対してモデルが異なる振る舞いをするよう訓練します。
多くの本番AIアプリケーションでは、最善の答えは二者択一ではありません。RAGは事実を提供できます。ファインチューニングは、モデルがその事実をどう使うか、指示にどう従うか、出力をどう整形するか、あるいは専門的なワークフローをどう扱うかを改善できます。
ファインチューニングとRAG:要点
アプリケーションが外部情報に基づいて回答する必要がある場合は、検索拡張生成、つまりRAGを使います。対象となるのは、社内ドキュメント、ポリシー、製品カタログ、サポート記事、法務・コンプライアンス資料、その他時間とともに変化する知識などです。
アプリケーションに、より一貫した振る舞いが必要な場合は、ファインチューニングを使います。具体的には、特定のトーン、出力形式、分類体系、抽出パターン、ワークフロー、または例によって示せるドメイン固有の応答スタイルなどです。
システムに、根拠のある知識と一貫したタスク実行の両方が必要な場合は、両方を使います。一般的なハイブリッド型のパターンは、RAGで関連するコンテキストを検索し、そのコンテキストをファインチューニング済みモデルで予測しやすい形式やスタイルに解釈させるというものです。
重要な違いはシンプルです。
- RAGは主に、回答を外部データに根拠づけるためのものです。
- ファインチューニングは主に、タスクに対するモデルの振る舞いを変えるためのものです。
Microsoftは、RAGをモデル出力をデータに根拠づける方法として説明し、RAGとファインチューニングは相互排他的な手法として扱うのではなく組み合わせられる、と同社のドキュメント「Microsoft FoundryにおけるRAGとインデックス」で述べています。OpenAIも同様に、教師ありファインチューニングを、特定のタスクに向けて例からモデルの振る舞いをカスタマイズする方法として、同社の「教師ありファインチューニングガイド」で説明しています。
検索拡張生成とは何か
検索拡張生成とは、AIアプリケーションが外部ソースから関連情報を検索し、その情報をモデルのプロンプトに含めたうえで回答を生成するアーキテクチャパターンです。
典型的なRAGの流れは次のようになります。
- ユーザーが質問します。
- システムが、インデックス、ドキュメントストア、ベクトルデータベース、検索エンジン、またはその他の知識ソースを検索します。
- 最も関連性の高いコンテンツのチャンクが、コンテキストとしてプロンプトに追加されます。
- 言語モデルが、検索されたコンテキストを使って応答を生成します。
- 設計によっては、アプリケーションに引用、出典参照、信頼度を示すシグナル、またはフォローアップの選択肢が含まれる場合があります。
RAGが有用なのは、モデルが事前学習で得た知識だけに頼る必要がないためです。リクエスト時に検索された情報を利用できます。そのためRAGは、企業のナレッジベース、カスタマーサポートシステム、ポリシー支援ツール、製品ドキュメント用ボット、最新データや独自データを参照する必要があるアプリケーションに適しています。
RAGに関する最初の研究論文では、パラメトリックメモリと、検索された非パラメトリックメモリを組み合わせたモデルが提示されました。ただし、その論文の結果は、研究者が評価した特定のアーキテクチャと実験に当てはまるものです。現代の商用RAG実装がすべて同じように振る舞う証拠として一般化すべきではありません。それでも、この論文は概念を理解するうえで有用な背景資料です。原論文については、arXivのRetrieval-Augmented Generation論文。
ファインチューニングとは何か?
ファインチューニングとは、既存のモデルを例に基づいて訓練し、特定のタスクでより高い性能を発揮したり、望ましいパターンにより確実に従ったりできるようにするプロセスです。
教師ありファインチューニングでは、訓練データは通常、入力と出力の例で構成されます。これらの例は、定義されたユースケースにおいて望ましい回答がどのようなものかをモデルに示します。時間をかけて、モデルはそうした例に沿うように振る舞いを適応させていきます。
ファインチューニングは、アプリケーションが次のようなものを必要とする場合によく使われます。
- 一貫した回答構造
- 特定の文体やトーン
- 分野固有の言い回し
- 安定した分類の振る舞い
- 構造化データ抽出のパターン
- プロンプトだけでは実現が難しい反復タスクへの対応
- ワークフローや判断パターンへの、より一貫した準拠
ファインチューニングは通常、大量に変化する事実知識を保存するための最初の選択肢としては最適ではありません。情報が頻繁に変わる場合、RAGシステムであれば多くの場合、モデルを再訓練することなく、基盤となる知識ソースやインデックスを更新できます。ファインチューニングに事実に関する例を含めることはできますが、最新の知識検索レイヤーの代替として扱うと、保守性や信頼性の問題を招く可能性があります。
また、ファインチューニングの利用可否、対応モデル、料金、データ取り扱いルールはプロバイダーによって異なり、時間とともに変わる可能性があります。チームはアーキテクチャ上の判断を固める前に、ベンダーの最新ドキュメントを確認すべきです。
本質的な違い:知識のグラウンディングか、振る舞いのカスタマイズか
ファインチューニング対RAGの議論で最もよくある誤解は、両者が同じ問題を解決するものだと思い込むことです。
そうではありません。
RAGが答える問いは、モデルは今、どの情報を使うべきか?
ファインチューニングが答える問いは、モデルはこのタスクを実行するとき、どのように振る舞うべきか?
モデルが洗練されてはいるものの古い回答を返すなら、ファインチューニングはおそらく最初に試すべき解決策ではありません。検索によって、より適切なグラウンディングを行う必要がある可能性が高いでしょう。
モデルが適切な文書にアクセスできているにもかかわらず、なお誤った形式で回答したり、適切でないトーンを使ったり、タスクのルール適用に一貫性がなかったりする場合は、ファインチューニングが役立つかもしれません。
実務では、多くのチームがまずプロンプト設計とRAGから着手します。モデルに信頼できる知識源へアクセスさせる必要があるからです。その後、評価を通じて、プロンプトの改善や検索設計では解決できない行動上の失敗が繰り返し見つかった場合に、ファインチューニングを検討します。
RAGを使うべき場面
アプリケーションが、外部情報、独自情報、変化する情報、あるいは監査可能な情報に基づいて回答を生成する必要がある場合、RAGは有力な選択肢になります。
最新情報や頻繁に変わる情報にはRAGを使う
答えが時間とともに変わる情報に依存する場合、通常はファインチューニングよりもRAGのほうがアーキテクチャとして適しています。例としては、商品の在庫状況、価格ルール、ポリシー更新、リリースノート、サポート文書、社内手順などが挙げられます。
RAGでは、システムがインデックスや知識源から入手可能な最新コンテンツを検索できます。これによって回答が常に正しいと保証されるわけではありませんが、モデルの訓練データだけに頼ることは避けられます。
独自情報や社内知識にはRAGを使う
多くのビジネスアプリケーションでは、営業支援資料、人事ポリシー、技術マニュアル、標準作業手順書、カスタマーサポート記事など、企業固有の資料に基づいてモデルが回答する必要があります。
RAGは、問い合わせ時にモデルをそうした資料へ接続できます。これにより、チームはあらゆる知識をモデルの重みに埋め込もうとするのではなく、管理されたリポジトリで知識を維持できます。
引用や追跡可能性が重要な場合はRAGを使う
ユーザーが回答の出典を確認する必要がある場合、RAGは多くの場合、よりよい出発点になります。RAGシステムは、回答に影響した元文書、該当箇所、リンクを示すように設計できます。
これは、エンタープライズ検索、コンプライアンスレビュー、法務支援、技術サポートなど、根拠のない文章ではなく証拠をユーザーが必要とするワークフローで特に有用です。
ただし、引用についても慎重に評価する必要があります。システムが関連文書を検索できたとしても、それを誇張したり、読み違えたり、不完全に使ったりした回答を生成する可能性があります。信頼性には、検索品質、チャンク化、ランキング、プロンプト設計、モデルの挙動のすべてが影響します。
知識集約型アシスタントにはRAGを使う
RAGは、大量の文書コレクションを対象に質問へ答えるアシスタントに適しています。例としては、次のようなものがあります。
- カスタマーサポートのナレッジベースアシスタント
- 社内ITヘルプデスクボット
- 開発者向けドキュメントアシスタント
- ポリシーおよび手順に関するアシスタント
- 製品に関するQ&&Aツール
- 調査およびナレッジマネジメントシステム
こうしたケースでは、主な課題はモデルに新しい文体を教えることではない場合が少なくありません。むしろ、適切なタイミングで適切な情報にアクセスできるようにすることが重要です。
ファインチューニングを使うべき場合
ファインチューニングは、質の高い例によって望ましい振る舞いを定義でき、モデルに特定のタスクをより一貫して実行させる必要がある場合に適しています。
一貫した出力形式にはファインチューニングを使う
モデルがアプリケーションに必要な構造を繰り返し生成できない場合、ファインチューニングが役立つことがあります。たとえば、特定のスキーマ、分類ラベルのセット、データ抽出形式、ワークフロー用の応答テンプレートに従った回答が必要な場合です。
最初はプロンプトで解決できることも少なくありません。しかし、その形式が複雑で、繰り返し使われ、あるいは事業上重要である場合、ファインチューニングによって対象タスクにおける振る舞いをより一貫させられる可能性があります。
ブランドボイスや応答スタイルにはファインチューニングを使う
望ましいトーンや文体を例で示せる場合、ファインチューニングは回答をそのスタイルに合わせるのに役立ちます。顧客対応アシスタント、営業支援ツール、コンテンツ運用ワークフローなどで有用になり得ます。
重要な要件は、例の品質です。ファインチューニングされたモデルは、提示されたパターンから学習します。一貫性のない例や品質の低い例は、一貫性のない結果を生む可能性があります。
ドメイン固有のタスク動作にはファインチューニングを使う
タスクによっては、単に事実へアクセスできるだけでは不十分です。ワークフローに沿って一貫した方法で推論し、ラベルを適用し、構造化フィールドを抽出し、あらかじめ定義された応答カテゴリの中から選ぶことが求められます。
ファインチューニングは、次のような用途で役立つことがあります。
- 分類タスク
- 構造化抽出
- ルーティングやトリアージの判断
- コンテンツを一貫した形式に書き換えること
- ドメイン固有の言い回しを適用すること
- タスク固有の反復的な指示に従うこと
これは、ファインチューニングが完璧な精度を保証するという意味ではありません。望ましい出力パターンが明確に定義され、学習例に反映されている場合に、有用なカスタマイズ手段になり得るという意味です。
プロンプトが反復的または壊れやすくなる場合にはファインチューニングを使う
アプリケーションによっては、同じ振る舞いのルールを何度も説明する長いプロンプトに依存しているものがあります。場合によっては、ファインチューニングによって、各プロンプトでそれらのルールを繰り返し書く必要を減らせることがあります。
とはいえ、レイテンシーやコストへの影響は実装次第です。ファインチューニングされたモデルによってプロンプト長を短縮できる場合はありますが、全体的な影響は、モデル、ベンダーの料金体系、トラフィック、インフラ、アプリケーション設計によって変わります。
両方を組み合わせて使うべき場合
RAGとファインチューニングは、互いを補完できます。
ハイブリッド構成は、多くの場合、次のような形になります。
- RAGは、関連する文書やデータを検索して取得します。
- プロンプトは、そのコンテキストをモデルに提供します。
- ファインチューニングされたモデルは、取得された情報に対して、一貫したタスクのパターン、トーン、形式、または判断プロセスを適用します。
これは、アプリケーションに事実に基づく根拠と予測可能な挙動の両方が求められる場合に有用です。
たとえば、サポートアシスタントは、RAGを使って関連する製品ドキュメントを取得し、そのうえでファインチューニングを用いて、一貫したトラブルシューティング形式で回答を生成できます。ポリシーアシスタントは、最新の人事ポリシーを取得し、ファインチューニングされたモデルを使って、従業員向けに標準化された文体で要約できます。文書処理ワークフローでは、参照用ガイダンスを取得し、ファインチューニングを使って、一貫したスキーマで項目を抽出できます。
ハイブリッドアプローチは、モデルが適切な情報にアクセスできているにもかかわらず、タスクの処理を誤る場合に特に有用です。RAGは内容を提供し、ファインチューニングはモデルがそれをどう使うかを改善します。
判断マトリクス:ファインチューニングとRAG
| 判断要因 | RAGが通常より適している場合 | ファインチューニングが通常より適している場合 |
|---|---|---|
| データの鮮度 | 回答が、現在の情報や頻繁に更新される情報に依存する。 | タスクの挙動が安定しており、主に変化する事実に依存しない。 |
| 独自知識 | モデルが社内文書、ポリシー、または製品データを使う必要がある。 | モデルが会社固有の挙動、トーン、または形式に従う必要がある。 |
| 事実に基づく根拠 | 取得したソースに根ざした回答が必要である。 | 定義されたタスクについて、より信頼性の高いパターンでモデルに応答させる必要がある。 |
| 出力の一貫性 | 検索によって必要な事実は提供されるが、形式についてはなおプロンプト設計が必要になる場合がある。 | 主な課題が、構造、ラベル、トーン、またはワークフロー実行の不一致である。 |
| メンテナンス | 再学習なしに、ソースコンテンツやインデックスを更新したい。 | 厳選した学習セットを維持し、挙動要件が変わったときに更新できる。 |
| 監査可能性 | ユーザーがソース参照や文書へのトレーサビリティを必要としている。 | ユーザーが主に、ソースに裏付けられた回答よりも、一貫したタスク遂行を必要としている。 |
| 評価の焦点 | 検索の関連性、回答の忠実性、引用の質、カバレッジが最も重要である。 | タスクの正確性、形式の遵守、トーンの一貫性、例の網羅性が最も重要である。 |
| レイテンシ | 検索により手順が増えるため、性能は検索、ランキング、生成設計に左右される。 | ファインチューニングにより、場合によってはプロンプト長を短縮できることがあるが、レイテンシはモデルとデプロイ方法に左右される。 |
| セキュリティとプライバシー | 制御は、データソース、検索レイヤー、ベンダー、デプロイ形態、アクセスルールに左右される。 | 制御は、学習プロセス、ベンダー、デプロイ形態、データ取り扱いポリシーに左右される。 |
このマトリクスは指針であり、普遍的なルールではありません。RAGやファインチューニングが常に、より安価、より高速、より正確、またはより安全であると一括りに主張できる信頼性の高い根拠はありません。そうした結果は、実装、モデル選定、データ品質、トラフィックパターン、評価設計、ベンダー価格、運用要件に左右されます。
よくある誤解
誤解1:新しい知識を追加する最善の方法はファインチューニングである
ファインチューニングは、モデルが例から何を学ぶかに影響を与えることはできますが、大量の変化する事実知識を管理する方法としては、通常は最善ではありません。アプリケーションに最新情報や独自情報が必要な場合、RAGはクエリ時に外部ソースから情報を取得するため、多くの場合、よりよい出発点になります。
誤解2:RAGはハルシネーションをなくす
RAGは根拠づけを改善できますが、事実としての正確性を保証するものではありません。RAGシステムでも、適切な文書を検索で見逃す、無関係なコンテキストを取得する、コンテンツのチャンク化が不適切である、パッセージのランキングを誤る、モデルへのプロンプトが効果的でない、といった場合には失敗し得ます。また、モデルが取得した情報を誤って解釈することもあります。
RAGは、適切に設計されていれば一定のリスクを減らせますが、ハルシネーションを万能に解決するものではありません。
誤解3:ファインチューニングとRAGは両立しない
両者は組み合わせることができます。Microsoftは、これらを併用可能なアプローチとして明確に提示しており、実務上の多くのアーキテクチャでは、知識の根拠付けに検索を使い、振る舞いのカスタマイズにファインチューニングを使っています。
誤解4:どちらか一方が常に安い、または速い
コストとレイテンシーは細部によって変わります。RAGでは、検索、ランキング、コンテキストの組み立てといった工程が追加される場合があります。ファインチューニングは、用途によってはプロンプトの長さを短くできることがあります。しかし、いずれの結果も保証されるものではありません。価格設定、インフラ、モデルの選択、キャッシュ、トラフィック量、ベンダーの契約条件がすべて関係します。
誤解5:ファインチューニングはあらゆるタスクを自動的に改善する
ファインチューニングの効果は、学習例の質と関連性に左右されます。タスクの定義が曖昧だったり、学習データに一貫性がなかったりする場合、ファインチューニングで問題が解決するとは限りません。チームはまず、プロンプト設計、ツール利用、検索品質、ワークフローの変更によって課題に対処できないかを評価すべきです。
選択前の評価チェックリスト
RAG、ファインチューニング、またはハイブリッド型のアプローチに取り組む前に、実際の利用状況を反映した評価セットを作成します。
含めるべき項目:
- 代表的なユーザーの質問やタスク
- 可能であれば、期待される回答またはゴールドスタンダードとなる出力
- エッジケースや曖昧な依頼
- 古い情報、欠落した情報、または矛盾する情報を含む例
- システムが非公開データを扱う場合は、セキュリティとアクセス制御のシナリオ
- 回答品質に関する人間によるレビュー基準
RAGシステムでは、以下を評価します。
- 検索器が適切なソース内容を見つけられるか
- チャンク化によって十分なコンテキストが保持されているか
- ランキングによって最良のパッセージが上位に提示されるか
- 生成された回答が、検索されたコンテキストに忠実であるか
- 引用やソース参照が正確で有用であるか
- 情報が欠落している場合に、システムが適切に対応できるか
ファインチューニング済みシステムでは、以下を評価します。
- タスクの精度
- フォーマットの遵守
- トーンと文体の一貫性
- 学習時に見ていない例に対する性能
- エッジケースにおける失敗パターン
- 過度なプロンプトを与えなくても、モデルが望ましいワークフローに従うかどうか
ハイブリッドシステムでは、両方のレイヤーを合わせて評価する。高品質な検索器があるからといって最終回答が優れているとは限らず、よくチューニングされたモデルでも、受け取っていない文書にもとづいて信頼性の高い回答をすることはできない。
実務診断:学習の前に失敗した箇所を特定する
Viva Paradoxが選択基準を確かめるために作成した、架空のサポート業務の演習です。入力と参照解答は教材として作成したもので、モデルの実測出力やファインチューニング実験の成果ではありません。
架空の製品名はDemoBoxです。廃止された文書R1には標準バックアップの保存期間が30日とあります。現行文書R2はR1を置き換えると明記し、保存期間を14日と定めています。また、OUTAGEを「サービスを利用できない」、DEGRADEDを「利用できるが遅い」と定義します。実際の製品仕様ではなく演習用の規則です。
提供された現行の参照文書だけを使い、標準バックアップの保存期間を答えてください。answerとsource_idを含むJSONで返してください。参照文書がなければ確認できないと伝え、古い文書で代用しないでください。
R2が提供された場合の参照解答:answerは14日、source_idはR2です。JSONの構文が正しいだけでは不十分です。30日という回答は事実確認で不合格になります。
| 演習で観察した失敗 | 最初に試す修正 | 次の段階へ進む前に確認する根拠 |
|---|---|---|
| 取得した文脈にR1しかなく、30日と答えた。 | 取り込み、版のメタデータ、廃止文書の除外、検索を修正し、R2がモデルに届くか再確認する。 | 取得した文書IDと版を記録する。文体を学習させても古いインデックスは修正されない。 |
| R2があり、14日と正しく答えるが、JSONの外に説明を付ける。 | 明確な指示、対応するスキーマ制約付き出力、アプリケーション側の検証を先に試す。 | 構文・スキーマの失敗と事実誤りを分けて記録する。一度形式を間違えただけで学習が必要になるわけではない。 |
| R2があるのに「利用できるが遅い」を繰り返しDEGRADEDではなくOUTAGEに分類する。 | ラベル定義と例を点検し、プロンプトの基準版と比較する。適切なラベル付きデータがあり、課題の誤りが続く場合に学習を検討する。 | 学習に使わない事例で評価する。厳密に決まった規則なら、学習済み分類器より通常のコードが簡単な場合もある。 |
| 閲覧権限のないチーム文書が利用者に渡る。 | 生成前に検索層とアプリケーションで認可を強制する。 | 権限の異なるアカウントで試す。拒否を求める指示や学習はアクセス制御の代わりにならない。 |
自分で実行できる小さな比較
現行文書への質問、参照がない質問、OUTAGE/DEGRADEDの分類例、権限検査を含む独立した評価セットを作ります。比較前に質問と参照解答を固定し、評価事例を学習データにコピーしません。三つの生成方法では、可能な範囲で評価入力、参照文書の版、検索設定、基盤モデルの系列をそろえます。(1)プロンプトと現行参照、(2)同じシステムに改善した指示や対応する出力制約を追加、(3)必要性が確認された場合のみファインチューニング版です。避けられない差は記録します。検索や権限の修正は別に試し、その効果を学習の効果と混同しません。
事例ごとに、必要な出典が検索されたか、回答が根拠に合うか、構造が有効か、ラベルが正しいかを記録します。権限検査の失敗、全体の応答時間、費用も別に残します。分母付きの件数で報告し、結果が分かれた事例を確認します。合計点だけでは、JSONは正しいのに古い事実を返すシステムを見落とします。この演習は精度・速度・費用の改善値を主張しません。
未見の事例でも観察された失敗を解消する、最小限の変更を選びます。変化する事実には検索を維持し、実証された振る舞いの問題には学習を検討します。併用は評価する候補であり、自動的に必要となる構成ではありません。
背景資料:Microsoftは、非公開・変動データの検索と、振る舞い・文体・課題遂行のためのファインチューニングを区別しています。上の診断事例は当サイト独自の教材です。